AIにニュースを選ばせたら一致率70%で止まった。自分の判断は60%だった|AIは「選ぶ」より「下げる」に使う
この記事の要点
毎日届く大量のメールとニュースを、小さなAIに仕分けさせられるか。導入する前に、実データで測った。メールは送信者を見るだけのルールで148件中142件(96%)が決まり、AIは文面から推測して外した。ニュースは中身を読まないと決まらないので、AIが勝てる場所のはずだった。ところが基準を4回書き直し、人の判断29件を実例として見せても、一致率は70%から上がらなかった。原因を調べるため、同じ30件を同じ人が付け直したところ、自分自身との一致は60%だった。正解そのものが40%ぶれていたのだ。ただし、ぶれ方には偏りがあった。「不要」の判断は人もAIも安定していて、ぶれるのは「読む」の判断だけだった。そこでAIに「読むものを選ばせる」のをやめ、「並べ替えて、不要なものを下げる」使い方に変えた。31件を93秒で並べ、上位8件が8連続で当たった。AIの精度を上げる前に、人の正解が安定しているかを測る。これがこの実験の結論である。
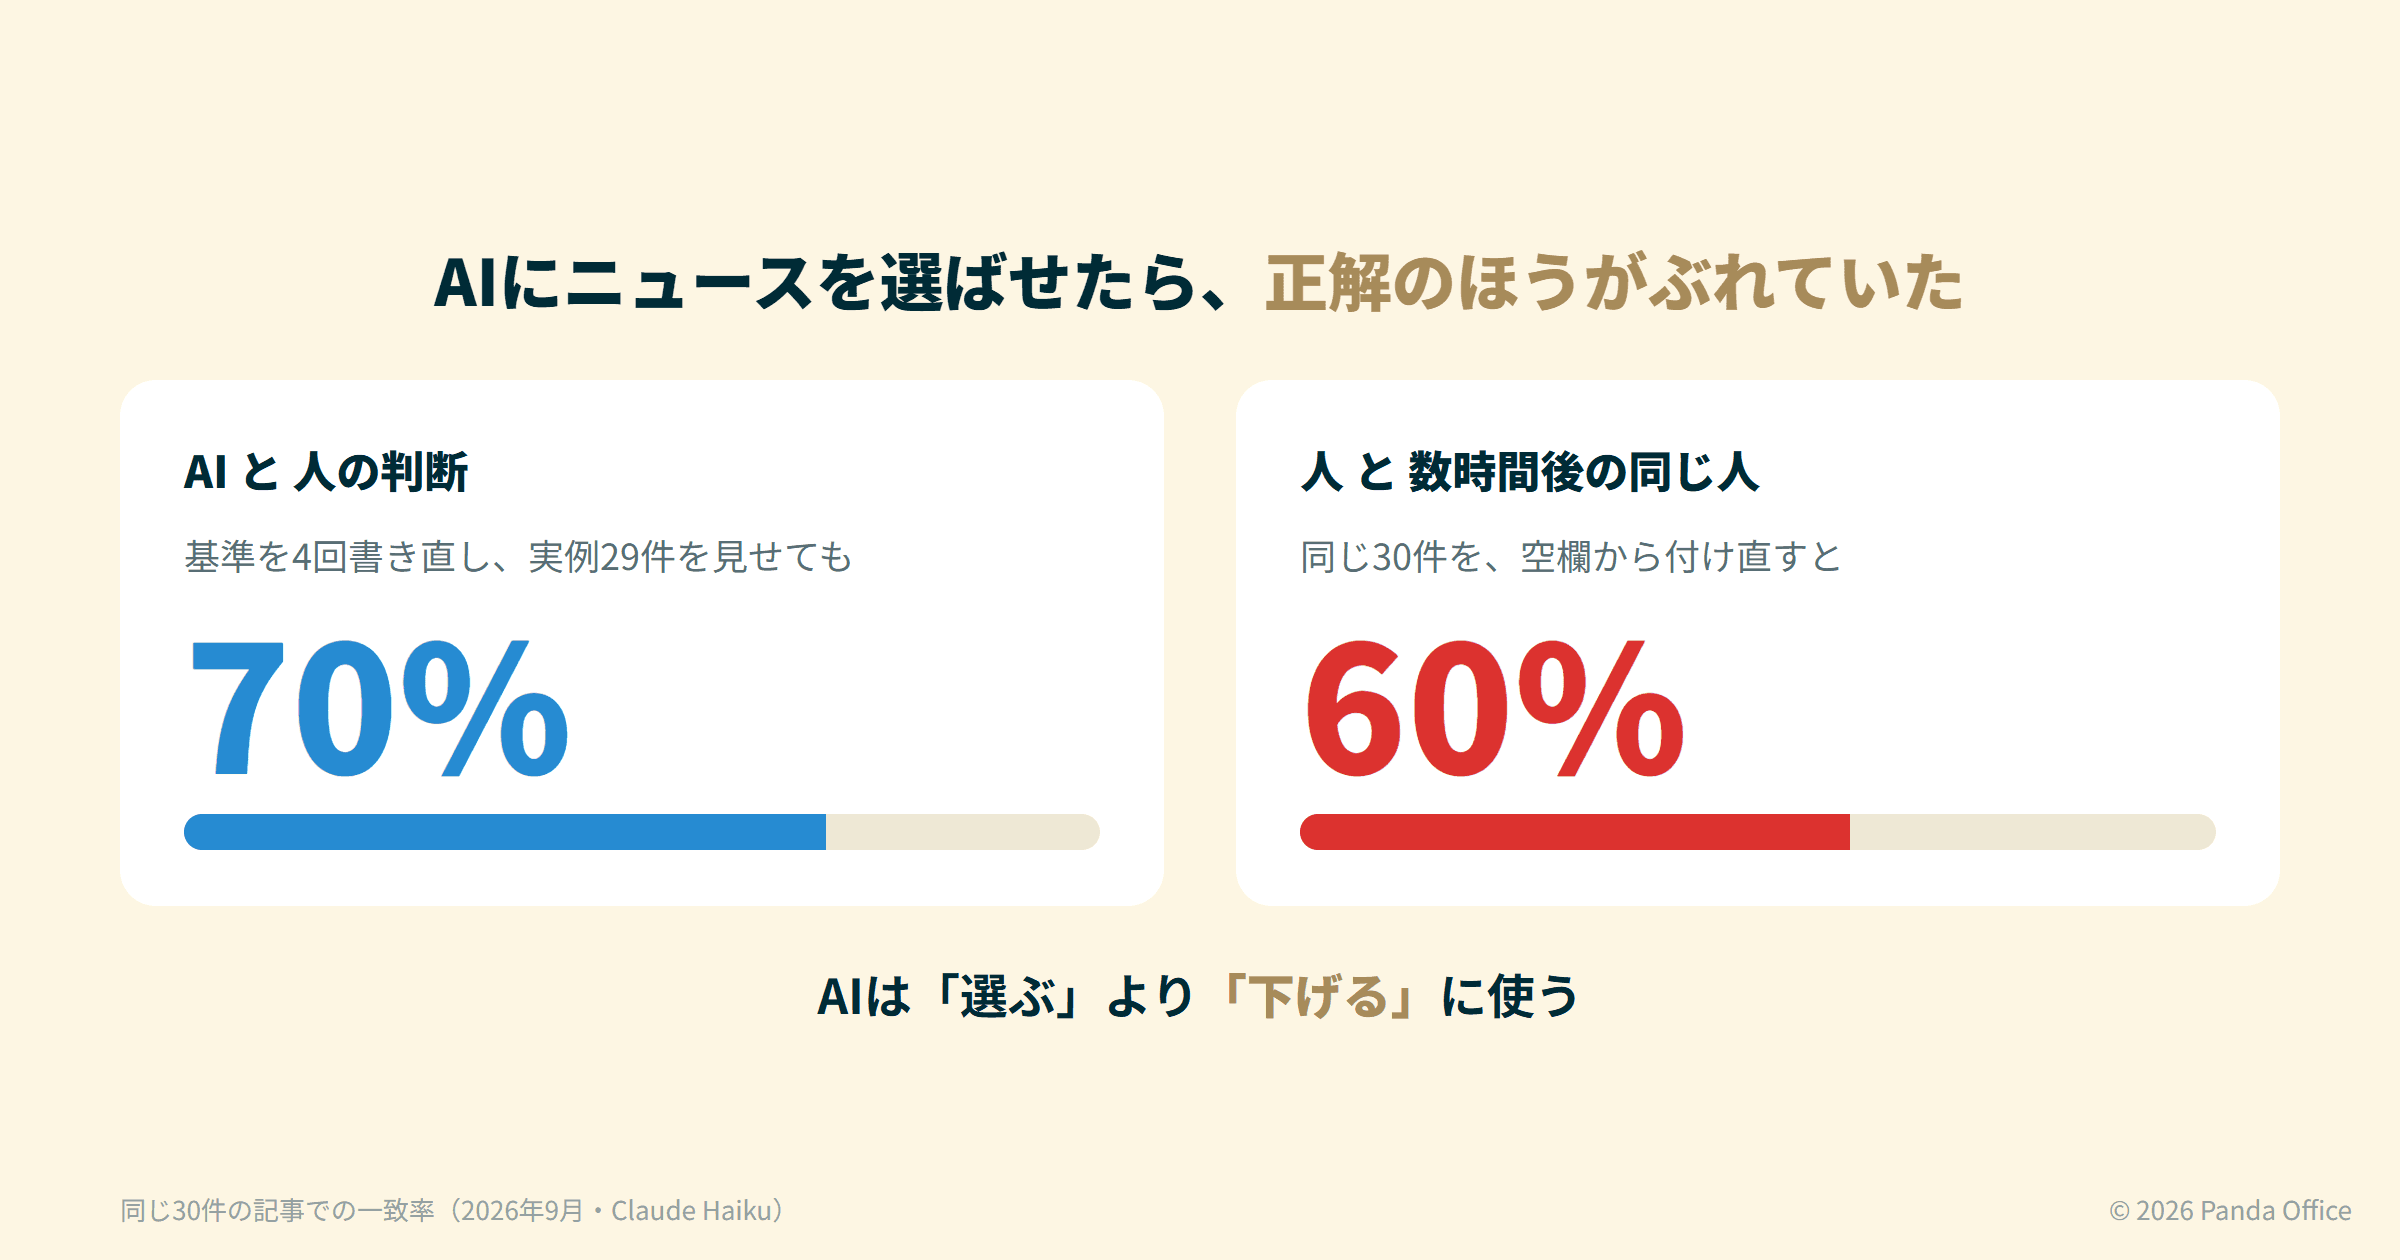
AIにニュースを選ばせたら、一致率は70%で止まった。基準を4回書き直しても上がらなかった。原因を調べたら、自分の判断が自分自身と60%しか一致していなかった。
この記事は、毎日のメールとニュースの仕分けに小さなAIを入れるかを、導入する前に実データで測った記録である。結論から言うと、どちらも「そのままの形では使わない」になった。ただ、その途中で、AIに業務を任せるときに最初に確かめるべきことが見えた。
何を測ったのか
毎日、大量のメールとニュースが届く。登録しているニュースのフィード5つだけで、1日1,653件ある。全部は読めない。読むべきものだけをAIが拾ってくれれば助かる。
ただし、いきなり任せることはしなかった。以前、ルールでメールを振り分けていたとき、通知すべき18通がすべて埋もれる事故を起こしたことがある。同じことをAIで繰り返したくない。
そこで、AIの判定は記録するだけで、実際の振り分けには使わない形で動かした。人が付けた判断と後から突き合わせ、一致率を出す。AIは Claude Haiku を使った。
実験1:メールは送信者で決まり、AIの出番はなかった
まずメールで測った。人がラベルを付けた148の送信者について、送信者を見るだけのルールとAIを比べた。
| 一致 | 1件あたりの時間 | |
|---|---|---|
| ルール(送信者を見るだけ) | 142 / 148(96%) | 1ミリ秒未満 |
| AI(文面から推測) | 3 / 6(50%) | 13.8秒 |
AIに投げたのは6件だけなので、数字の大小は参考程度だ。それでも、通知すべき2件を両方とも落としたことは見過ごせない。
理由は単純だった。AIは、その送信者が誰かを知らない。取引先から来たメールが重要かどうかは、相手との関係で決まる。文面には書いていない。メールの仕分けは送信者で決まる仕事で、AIの出番はなかった。 AIは入れないと決めた。
実験2:ニュースは基準を4回書き直しても70%
ニュースは逆である。同じ媒体から、読む価値のある記事とない記事が混ざって届く。発行元では決まらず、中身を見ないと分からない。AIが勝てる場所のはずだと考えた。
同じ30件の記事で、AIへの基準を4回書き直した。
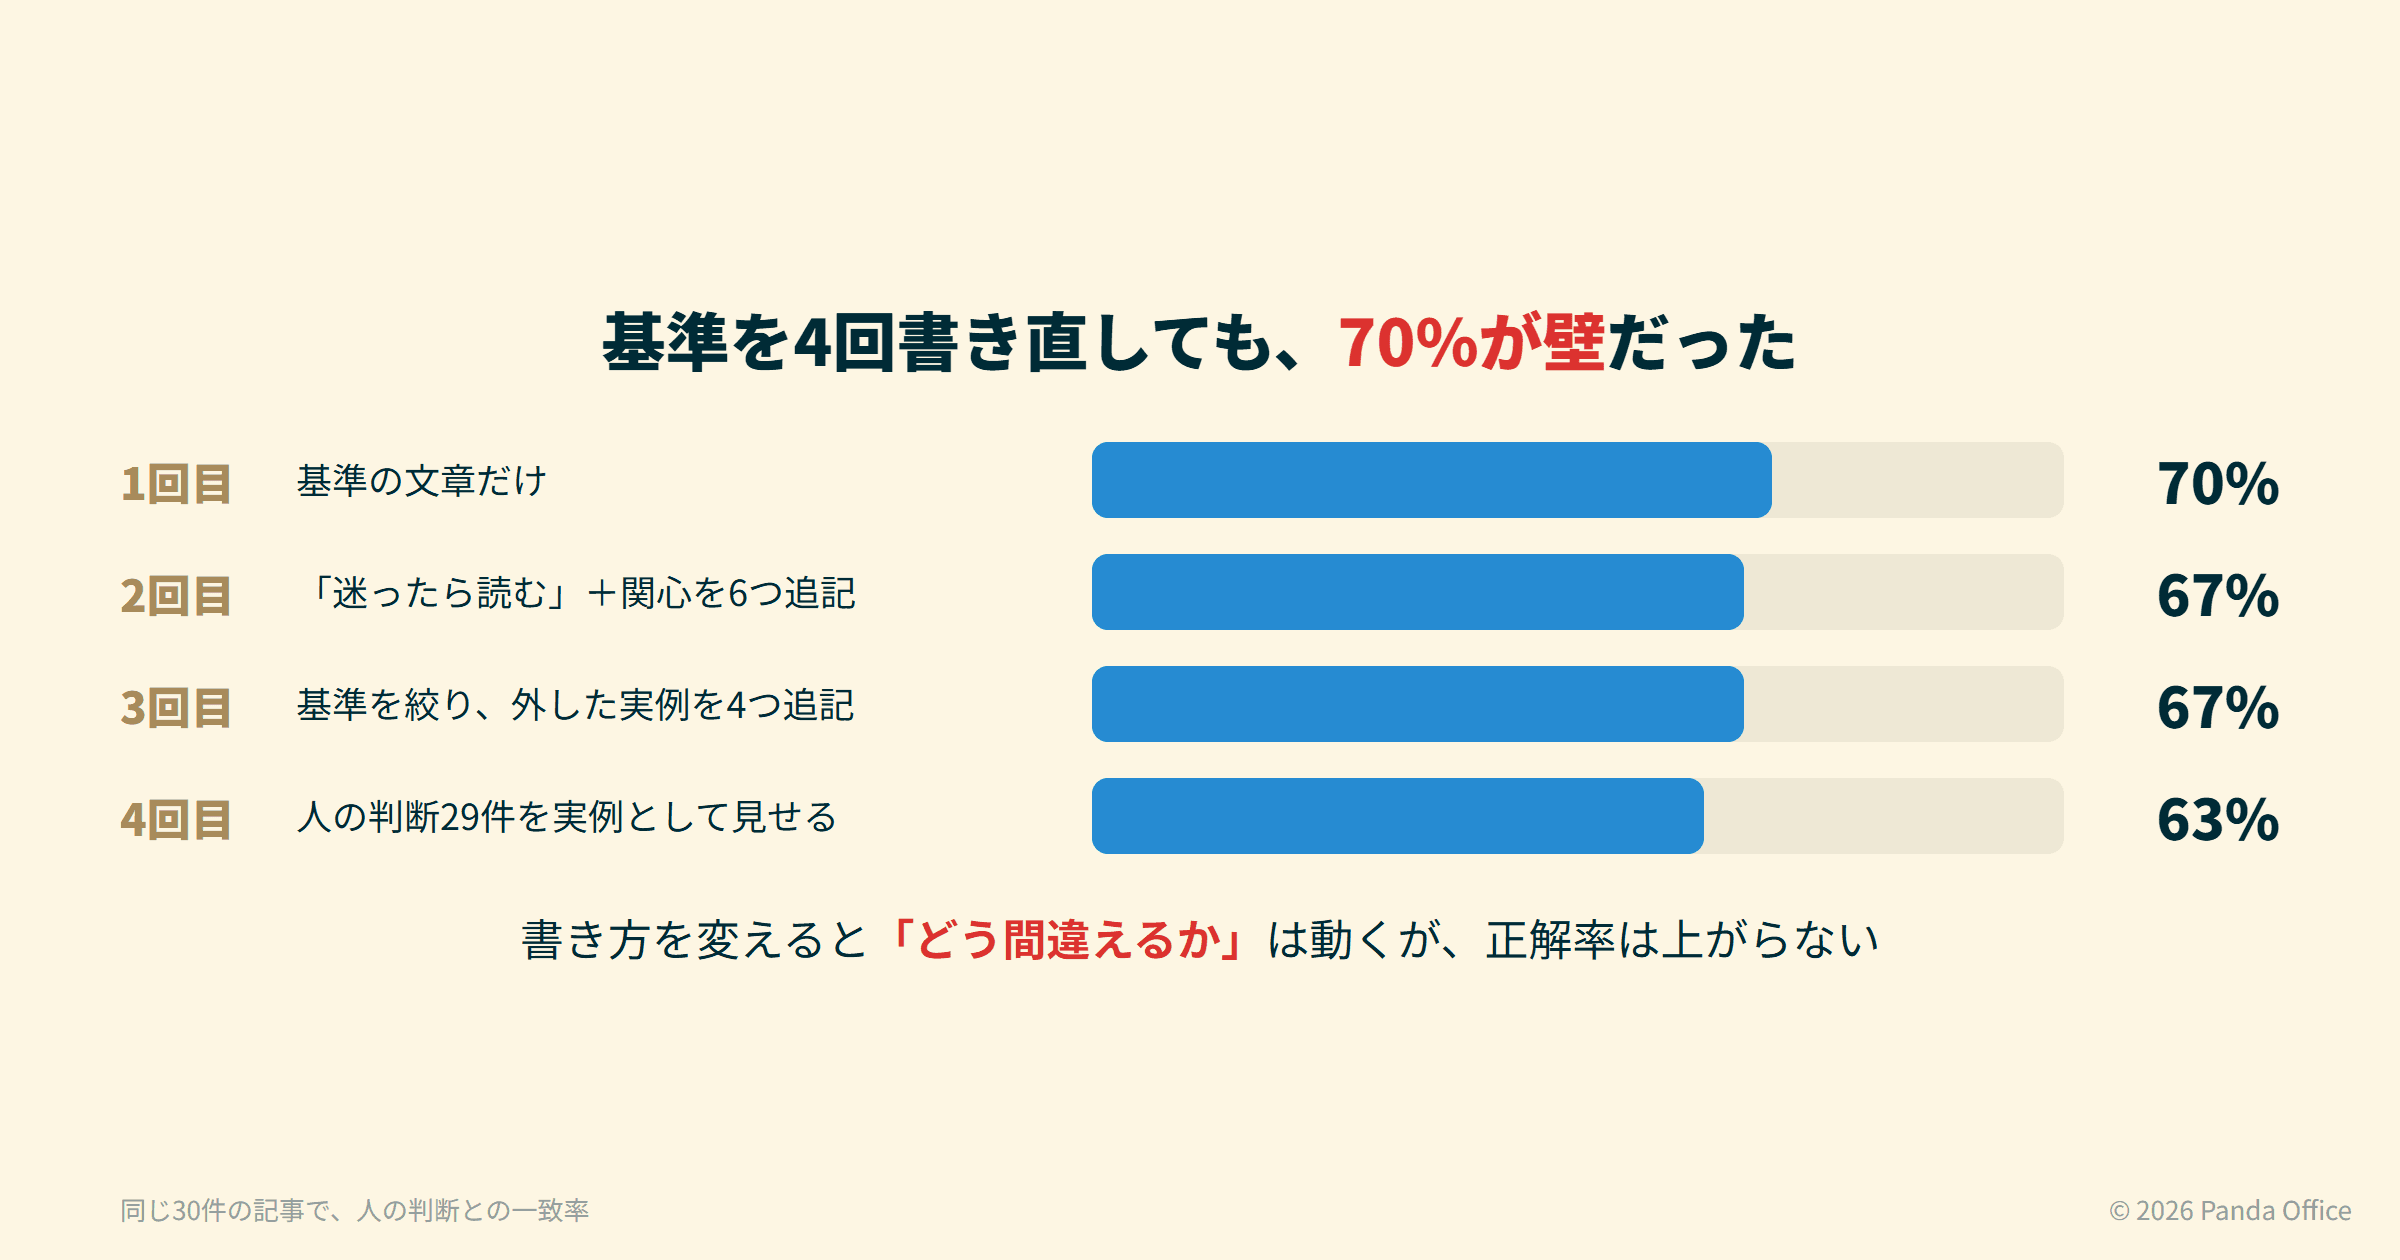
| 回 | やったこと | 一致 | 見落とし | 拾いすぎ |
|---|---|---|---|---|
| 1 | 基準の文章だけ。「迷ったら不要」と明記 | 70% | 9 | 0 |
| 2 | 「迷ったら読む」に変え、見落とした関心を6つ追記 | 67% | 3 | 3 |
| 3 | 基準を絞り、外した実例を4つ追記 | 67% | 5 | 4 |
| 4 | 人が下した判断29件を実例として見せる | 63% | 5 | 4 |
70%が壁だった。 基準の書き方を変えると「どう間違えるか」は動く。見落としを減らせば拾いすぎが増える。だが正解率は上がらない。29件の実例を見せても変わらなかった。
外し続けた記事を並べると、理由が見えてくる。
- AIが見落とした記事:ニセ警察の詐欺、カメラの新製品、メルカリの株、変わった住所の本
- AIが拾いすぎた記事:クラウドの週次まとめ、新しいAIモデル、AIの動画編集
AIは「AIやクラウドの記事なら読むはずだ」と、筋の通った推論をしている。一方で人は、仕事と関係のないカメラや本を読み、仕事に近いAIの記事を捨てている。この判断は、タイトルの中に手がかりがない。実例を見せても推測できない。
自分の判断が、自分と60%しか一致しなかった
ここで、正解として使っていた「人の判断」そのものを疑った。同じ30件を、同じ人(筆者)が、数時間あけて付け直した。
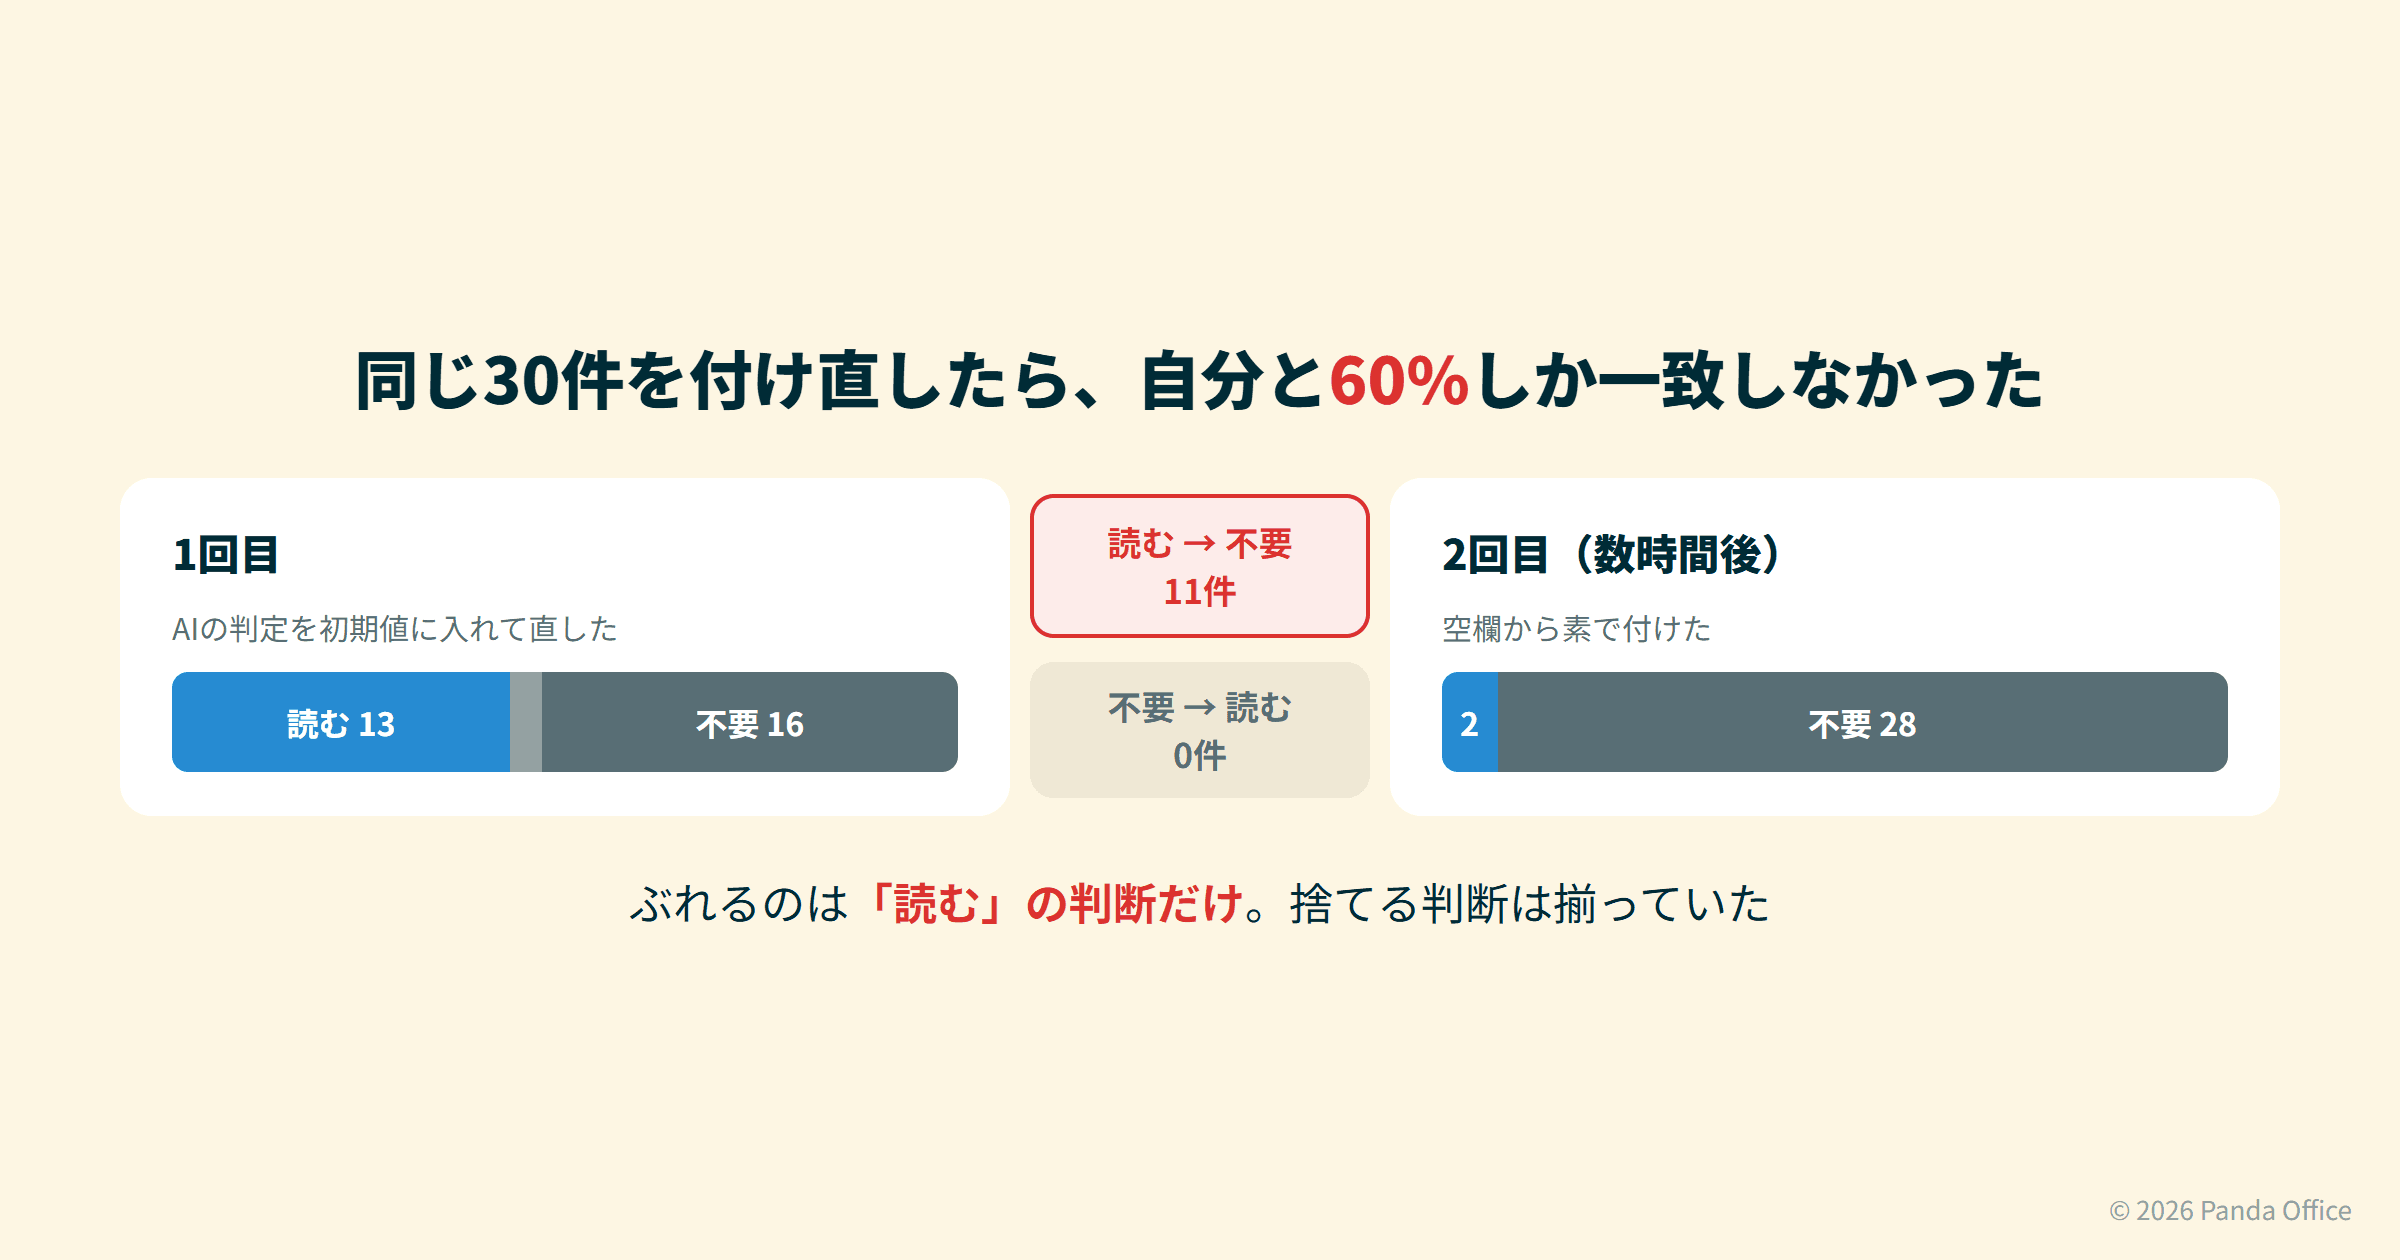
| 読む | あとで | 不要 | |
|---|---|---|---|
| 1回目(AIの判定を初期値に入れた状態で直した) | 13 | 1 | 16 |
| 2回目(空欄から素で付けた) | 2 | — | 28 |
一致は30件中18件、60%だった。 11件が「読む」から「不要」に変わり、逆は0件だった。
1回目は、AIの判定を初期値にした表を直す形で付けていた。そのとき私は「AIは不要と言っているが、これは読むだろう」と、意識して拾う方向に動いていた。採点するための判断であって、実際に読むかどうかの判断ではなかった。
つまり、この仕事には安定した正解がない。正解が40%ぶれるものをAIに当てさせて、70%以上を求めるのは筋が通らない。4回の調整は、的の方が動いていた。
ただし、捨てる判断だけは揃っていた
ぶれ方には偏りがあった。1回目に「不要」とした記事は、2回目もすべて「不要」だった。ぶれたのは「読む」の判断だけである。
AIも同じだった。1回目の測定で、AIの「拾いすぎ」は0件だった。人もAIも、捨てる判断は安定していて、拾う判断がぶれる。
だとすれば、AIに「読むものを選ばせる」のは無理がある。正解が定義できないからだ。一方で「明らかに不要なものを下げる」なら成り立つ。
| AIの使い方 | 成り立つか |
|---|---|
| 読むべきものを選ぶ | ✗ 正解が定義できない。人自身が40%ぶれる |
| 明らかに不要なものを下げる | ○ 人もAIも、捨てる判断は安定している |
| 全部見せて、並べ替える | ○ 外しても下がるだけで、消えない |
並べ替えなら、93秒で上位が当たった
そこで、AIに31件をまとめて点数付けさせ、並べ替えた。結果はこうだ。
- 31件を93秒で並べた。 1件ずつ聞くと8分かかる。まとめて聞くと、記事どうしを比べられるぶん判定も素直になる
- 上位8件が、8件続けて当たった。 1回目の採点で人が「読む」とした記事が、上から8件並んだ
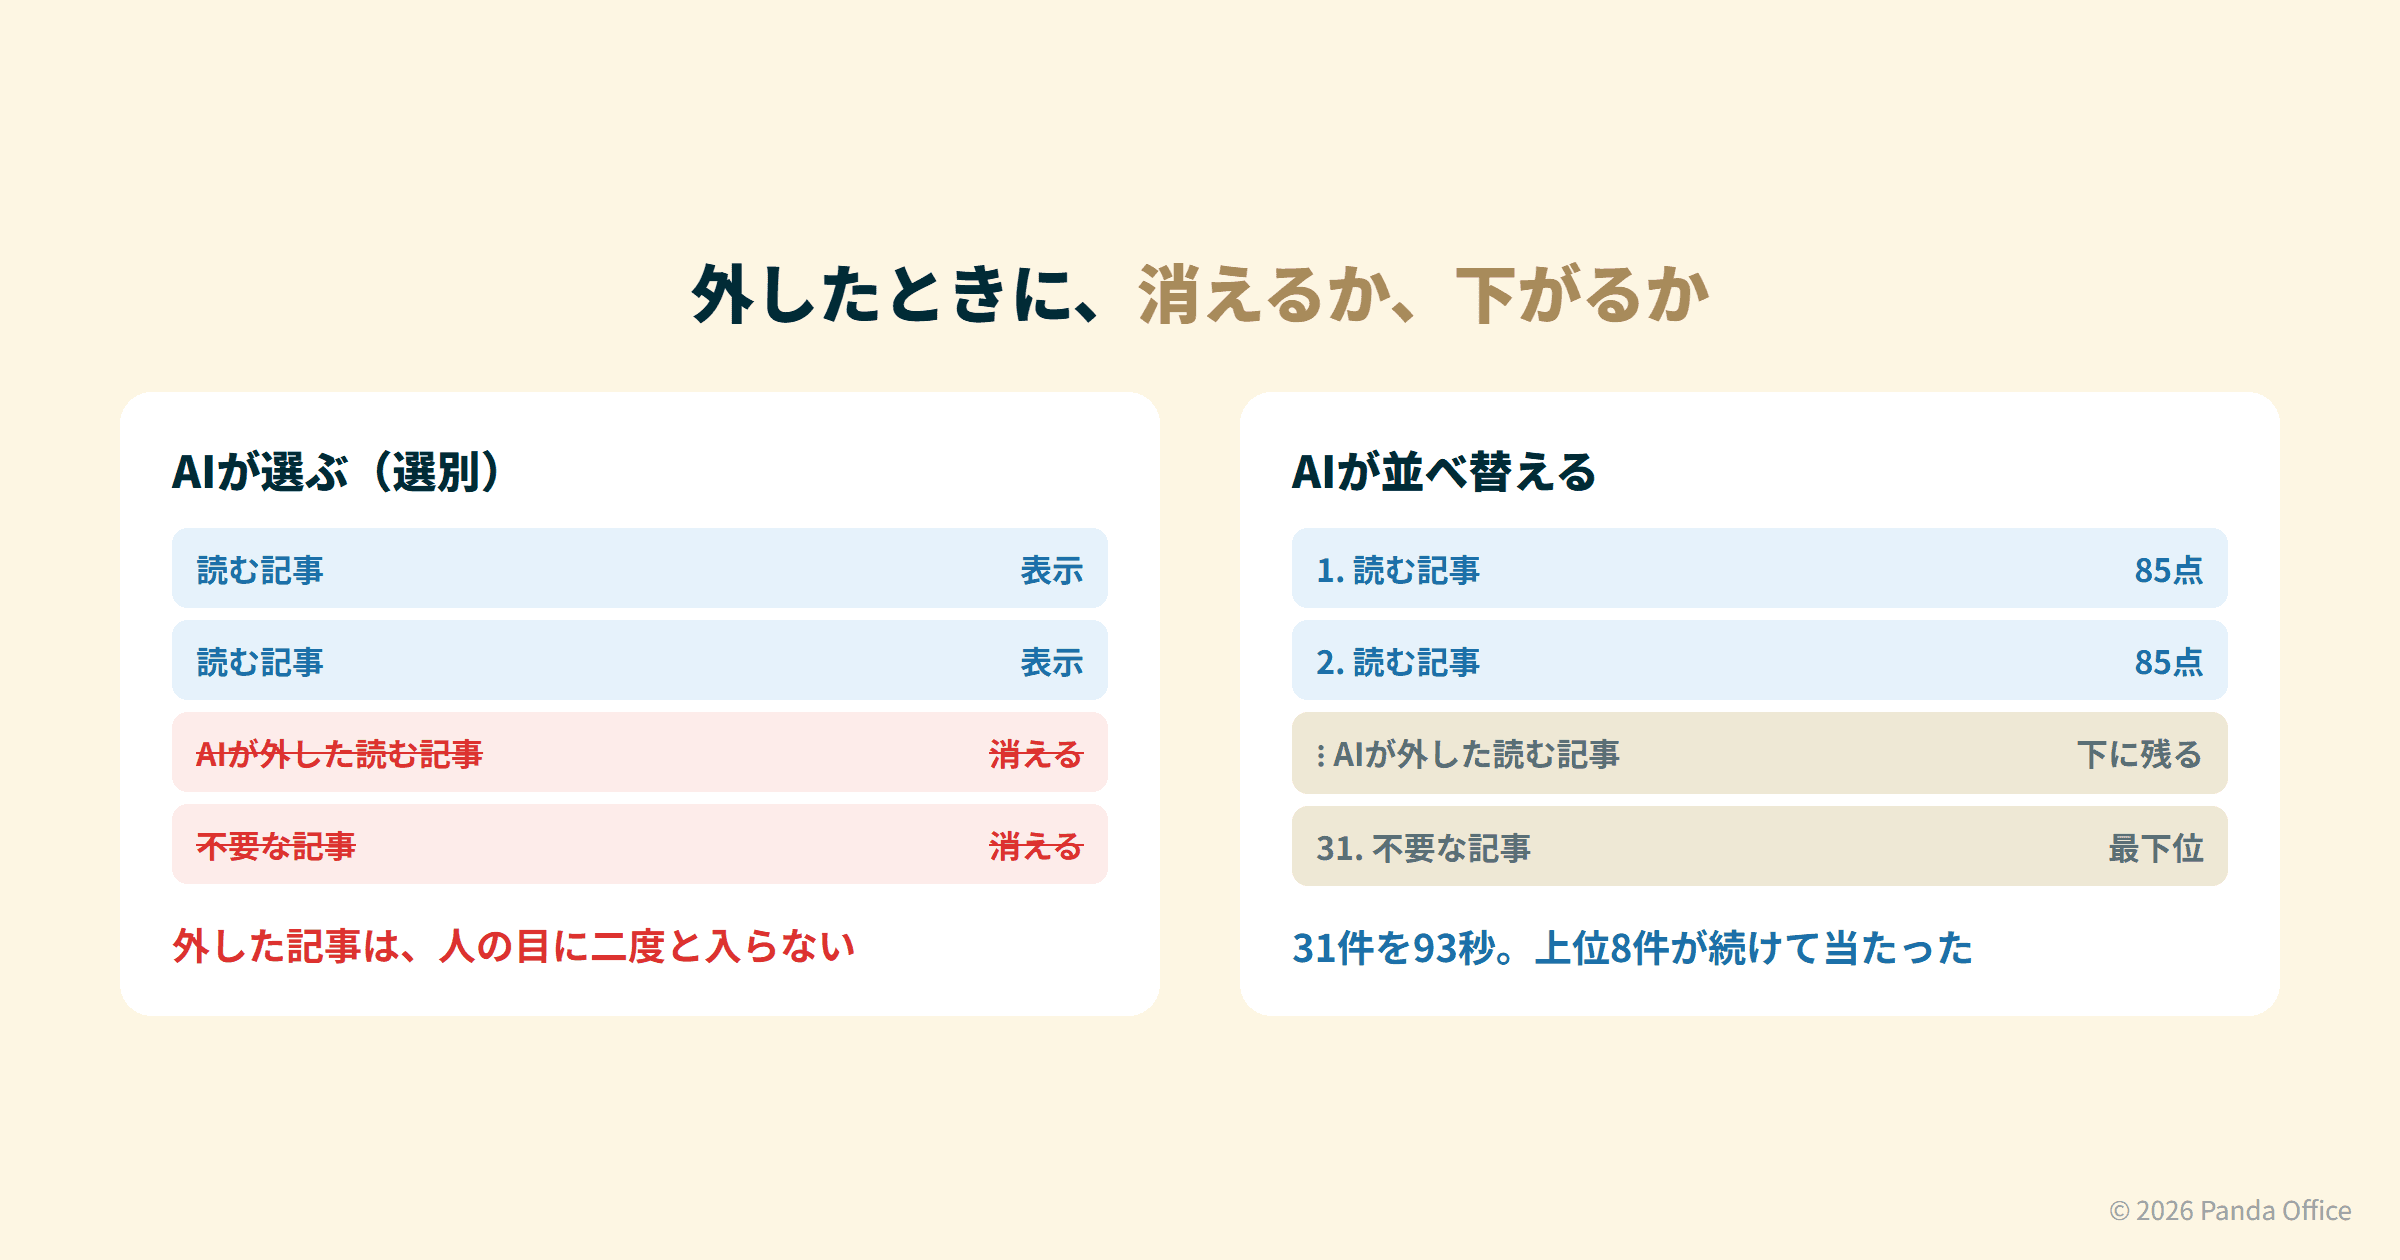
同じ70%でも、選別と並べ替えでは意味が違う。選別で外すと、記事は消える。並べ替えで外しても、下に下がるだけで残る。 間違えたときの損害が小さい。精度を上げようとするより、間違えても困らない使い方に変えるほうが早かった。
ついでに、AIを呼ばずに手元のPCの小さなモデル(文章の近さを数値にする埋め込みモデル)で並べ替えられないかも試した。速さは40倍以上になった。だが上位10件の重なりは半分しかなく、4通り試しても改善しなかった。埋め込みは言葉の近さを見ていて、AIは読む価値を見ている。 測っているものが違うので、片方でもう片方を代用できなかった。
AIに仕分けを任せる前に確かめる3つのこと
この実験から、AIに判断を任せる前に確かめることを3つにまとめる。
- ルールで決まらないか。 メールのように、送信者や取引先で決まる仕事なら、AIより表のほうが速く正確だ
- 人の正解は安定しているか。 同じ人が同じものを日をあけて付け直してみる。自分自身と一致しないなら、AIの精度を上げても意味がない。付け直すときは、AIの答えを見せずに付ける
- 間違えたときに何が起きるか。 選ばせて外すと消える。並べ替えて外すと下がるだけだ。損害が小さい使い方を先に選ぶ
AIの精度を問う前に、正解のほうを測る。地味だが、これを飛ばすと、動いている的に向かって何度も調整を繰り返すことになる。
AIに業務を任せるときの考え方はAI社員とは?に、うまくいかなかった事例はAI活用の失敗と教訓にまとめている。
この実験の限界
- 件数は小さい。 ニュースは30件、メールのAI判定は6件である。傾向を見るための実験で、精度の数字をそのまま一般化はできない
- 判断したのは1人(筆者)だけだ。 人によってぶれ方は違うはずである
- AIは Claude Haiku の1種類だけで測った。 上位のモデルなら70%の壁が動く可能性はある。ただし正解が60%しか安定していない以上、壁を越えても測りようがない